Issue
Tutto su Jev, il nuovo modello AI che non scrive
Iscriviti per non perderne una
Tutto su Jev, il nuovo modello AI che non scrive
Un modello nuovo che non scrive niente: risponde a domande chiuse e dice quanto è sicuro. Serve alla metà del lavoro di cui non parliamo mai.
Iscrivetevi su thesundayprompt.com per ricevere i numeri; per post e news quotidiane seguite The Sunday Prompt anche su LinkedIn e su Instagram.
Il 15 settembre una società americana di cui nessuno aveva sentito parlare, TypeSafe AI, ha annunciato il suo primo modello. Si chiama Jev, l'ha presentato il fondatore Diogo Almeida, che in OpenAI aveva lavorato ai metodi da cui poi è nato ChatGPT; arriva dopo due anni di lavoro riservato e 40 milioni di dollari raccolti.
La particolarità sta in quello che il modello fa. Jev non scrive una parola. Non tiene una conversazione, non riassume un contratto, non redige una lettera. Gli si dà un testo e una domanda a risposta chiusa, e lui risponde barrando una casella, con accanto la percentuale di sicurezza con cui l'ha barrata. Tutto qui. La risposta arriva in un tempo che sta fra i 70 e i 500 millisecondi, meno di un battito di ciglia, e costa 4 centesimi di dollaro ogni milione di parole che gli date da leggere.
La mia tesi è che questa cosa interessi i professionisti più di quanto sembri, e per una ragione che non è la velocità. Il lavoro di uno studio si divide in due mestieri diversi: produrre testi e smistare materiale. Scrivere un parere è il primo. Guardare quarantasei email arrivate nel fine settimana e decidere quali tre meritano una risposta oggi è il secondo. Finora per entrambi abbiamo usato lo stesso strumento, cioè il modello che scrive, pagandolo come tale e aspettando i suoi tempi. Jev è costruito per la seconda metà soltanto, e porta con sé una cosa che ai modelli di conversazione manca: dichiara quanto è sicuro di ogni risposta che dà. Tale caratteristica consente di decidere in anticipo che cosa può andare avanti da solo e che cosa deve finire sul tavolo di una persona.
Come funziona, in parole povere
Il meccanismo ha due pezzi. Il primo si chiama stato ed è semplicemente il materiale su cui si ragiona: il testo di una email, una scheda cliente, il verbale di una riunione. Il secondo sono le domande, che si scrivono in anticipo e hanno risposte già stabilite.
Le domande si fanno tutte in una volta e il modello le valuta in parallelo, ciascuna in modo indipendente dalle altre. È la differenza pratica più vistosa rispetto a una chat: se a ChatGPT chiedete quindici cose, le affronta una dopo l'altra e il tempo si somma; qui aggiungere la quindicesima domanda cambia pochissimo il tempo di risposta, e costa qualche frazione di centesimo in più.
Le risposte possibili sono di tre tipi soltanto.
Le tre crocette
Il primo tipo è la scelta fra opzioni che decidete voi: materia, ufficio competente, tipo di pratica, fino a un massimo di 255 alternative. Per ognuna si scrive il criterio, cioè la riga che spiega quando si applica. Il modello restituisce l'opzione scelta e la probabilità attribuita a ciascuna delle altre.
Il secondo è il voto su una scala: da due a dieci livelli ordinati, descritti a parole («cliente tranquillo che espone fatti», «cliente contrariato ma civile», «cliente molto arrabbiato»). Torna indietro un punteggio, che può cadere anche a metà strada fra due livelli.
Il terzo è la domanda vero o falso, che non torna come un sì o un no ma come una probabilità fra 0 e 1. Alla frase «il messaggio esprime urgenza» il modello può rispondere 0,999.
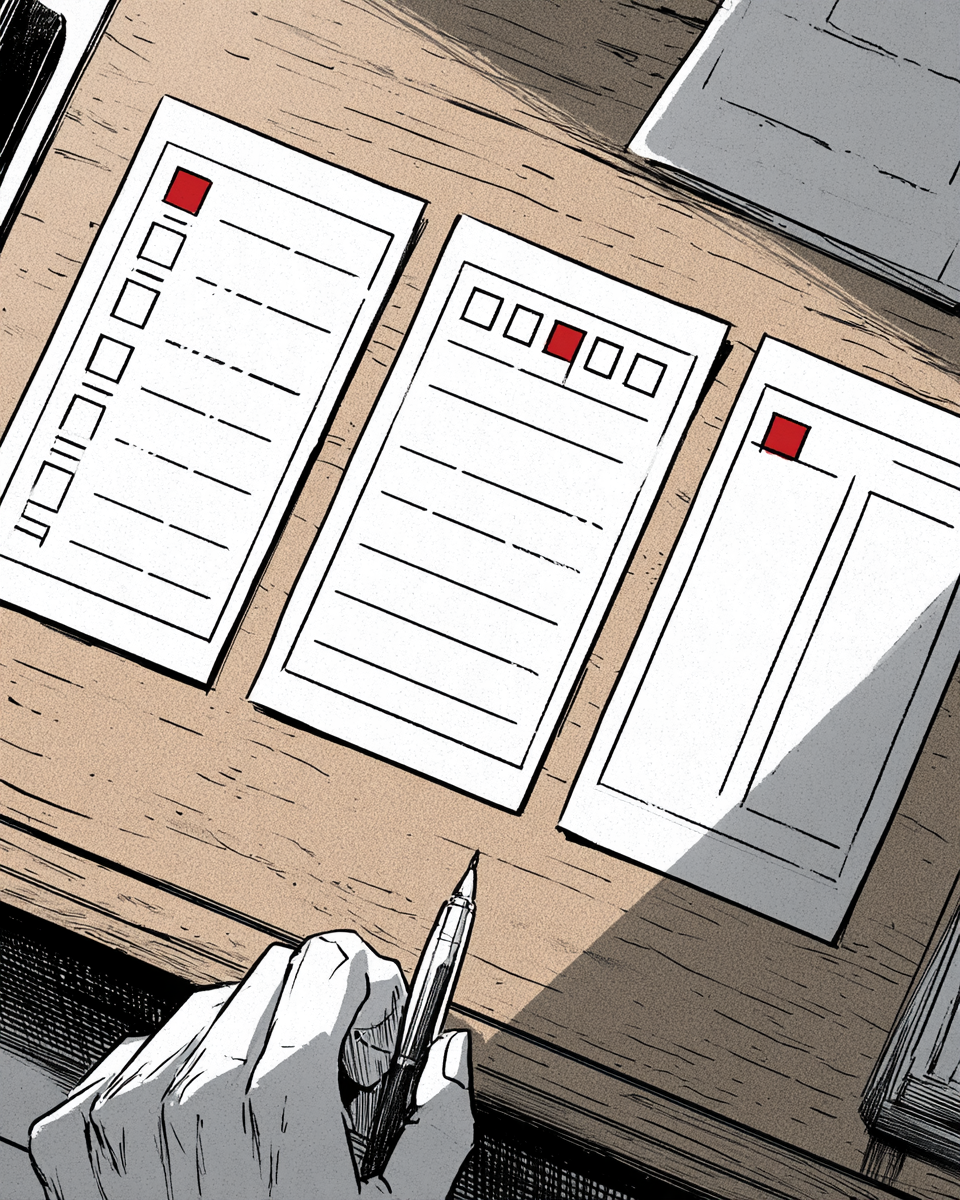
💡 Come si presenta, in concreto (ipotetico). Sullo stesso messaggio di posta si possono mettere insieme, in una sola richiesta: materia (scelta fra le voci dello studio), urgenza (vero o falso, con probabilità), tono del cliente (voto su tre livelli), c'è una scadenza nominata nel testo (vero o falso), il mittente è già cliente (vero o falso). Quello che torna indietro è una riga di dati, che un foglio di calcolo o un gestionale possono ordinare e filtrare come qualsiasi altro dato.
Attenzione perché se la risposta che vi serve è un testo — la bozza della lettera, il riassunto della pratica — questo strumento non c'entra e dovete restare su Claude o su ChatGPT.
La parte utile è il numero accanto alla risposta
Ogni risposta arriva accompagnata da una confidenza, cioè da quanto il modello si sbilancia. Se su cinque materie ne dà una al 96 per cento, la confidenza è alta; se ne dà due al 40 e 38 per cento, è bassa, e quel caso è genuinamente dubbio.
Da qui discende una regola di lavoro che a noi è familiare, perché è quella che si usa coi collaboratori: si stabilisce prima una soglia, e sopra quella soglia la pratica prosegue per la sua strada, sotto quella soglia arriva sul tavolo di chi deve guardarla. La differenza rispetto a un modello di conversazione è che qui la soglia è un numero scritto, uguale per tutti i documenti, e non dipende dal fatto che il modello quel giorno sia sembrato sicuro di sé. I modelli che scrivono, anche quando gli si chiede di dichiarare la propria sicurezza, tendono a essere sbilanciati verso l'alto e poco costanti.
Un esempio vero, preso dalla documentazione ufficiale, riguarda una cosa che in uno studio legale costa tempo tutti i giorni: controllare le citazioni. Hanno preso otto citazioni prodotte da un modello di conversazione a sostegno di altrettante affermazioni, e ne hanno modificate quattro di proposito: una inventata di sana pianta, una che diceva il contrario di quanto le si faceva dire, due che semplicemente non sostenevano l'affermazione. Il controllo automatico ha riconosciuto come buone le quattro corrette, con confidenza dallo 0,93 in su, e ha individuato tutte quelle modificate.
Il procedimento è lo stesso che farebbe un praticante diligente: prima si verifica che la frase citata esista davvero nel documento, poi si legge il contesto attorno e si decide se regge l'affermazione. La differenza sta nel fatto che quel lavoro, su ottanta citazioni invece che su otto, diventa questione di secondi e di centesimi.
Come si attiva
Provarlo è facile, metterlo al lavoro richiede che qualcuno scriva qualche riga di codice.
Per provarlo si va su typesafe.ai e si apre un account. L'accesso in questo momento è a rilascio progressivo, con una lista d'attesa che gli sviluppatori stanno smaltendo; chi entra riceve 5 dollari di credito senza mettere la carta di credito, e considerato il prezzo significa qualche centinaio di migliaia di domande. Dentro la console c'è una pagina che si chiama Playground: si incolla un testo nel riquadro dello stato, si scrive la domanda nel riquadro delle domande, si preme e si legge la risposta con le sue percentuali. Non serve sapere nulla di programmazione e ci si mette due minuti; è il modo per capire, su un documento, se le risposte che dà vi convincono.
Per usarlo davvero serve invece che il modello venga interrogato da un programma, perché l'utilità nasce quando le email o i documenti sono quattrocento e non uno. Chi ha un informatico di fiducia gli fa leggere la documentazione, che è breve. Chi lavora con Claude Code o con Codex, come racconto da qualche numero, può farselo costruire dall'agente: TypeSafe ha pubblicato una skill che insegna all'agente come si scrivono le domande, e si installa con due comandi.
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Dopodiché si chiede all'agente, in italiano, di costruire la cosa che serve — «prendi questo file di email esportate, fai a ognuna queste cinque domande, mettimi il risultato in un foglio» — e lui scrive il programma che chiama il modello. La chiave API di accesso si genera dalla console, nella pagina delle chiavi, e si incolla per l'agente.
Quello che non fa
La società pubblica una pagina in cui elenca i difetti del proprio modello, aggiornata al 17 settembre. È un documento che vale la lettura, e da cui prendo le quattro cose che secondo me contano di più per noi.
- Legge alla lettera. Risponde alla domanda che avete scritto, non a quella che avevate in mente. Le negazioni, le condizioni sottintese e le parole che restringono il campo le prende alla lettera, sicché la domanda va scritta con la stessa cura di una clausola.
- Non conta e non fa conti. Non è una calcolatrice e non sa contare in modo affidabile quante volte una parola compare in un atto. I conteggi e le somme devono restare fuori, nel programma.
- Fatica sulle date. Confrontare due scadenze e stabilire quale viene prima è un'operazione che conviene non chiedergli.
- Peggiora se gli date troppo. Lo stato deve contenere quello che serve alla domanda. Un fascicolo passato per intero, con dentro tutto, abbassa la qualità delle risposte. Il limite tecnico è di 64.000 token, all'incirca un centinaio di pagine, e solo testo: immagini, audio e video restano fuori.
⚠️ Sui numeri dichiarati. Tutti i confronti che leggete in giro — 200 volte più veloce, 400 volte più economico — vengono dalle misurazioni della società stessa, su prove costruite dal suo team, e alla data di oggi nessuno li ha riprodotti dall'esterno. Lo dichiarano loro per primi. È dubbio che i rapporti restino quelli anche su lavori normali. Lo stesso vale per le dimostrazioni che hanno fatto girare in questi giorni, con bot che giocano o pilotano droni: girano tutte dentro simulatori, non su macchine vere.
Aggiungo un dato che tempera l'entusiasmo e che viene sempre dalla loro documentazione: su un insieme di quaranta ricerche giuridiche, usando il modello per riordinare i risultati, la percentuale di volte in cui il documento giusto arrivava primo è passata dal 5 al 18 per cento, e quella in cui compariva fra i primi dieci dal 38 al 62. È un miglioramento netto, ma il valore assoluto dice che di una ricerca del genere, oggi, ci si fida per restringere il campo e non per risolvere la questione.
Il prompt della settimana
Questo esercizio serve anche a chi Jev non lo userà mai, perché la parte difficile sta a monte: accorgersi quali decisioni prendete a ripetizione, e riscriverle in modo che qualcun altro possa prenderle al posto vostro. Funziona su Claude o su ChatGPT.
Fai da analista dei miei processi di lavoro.

Ti descrivo una attività ripetitiva del mio studio professionale.
Il tuo compito è scomporla nelle singole decisioni che prendo
mentre la svolgo, e riscrivere ciascuna come una domanda a
risposta chiusa.

Per ogni decisione scrivi:
1. la domanda, in una riga, senza sottintesi e senza negazioni;
2. il tipo: scelta fra opzioni, voto su una scala, oppure vero/falso;
3. se è una scelta, l'elenco completo delle opzioni, ciascuna con
   la riga che spiega quando si applica, più una opzione "nessuna
   delle precedenti";
4. quali informazioni bisogna avere sotto gli occhi per rispondere;
5. che cosa succede quando la risposta è dubbia: chi la guarda.

Separa le decisioni di giudizio da quelle che sono semplici
verifiche su un dato (una data, un importo, la presenza di un
allegato): queste ultime elencale a parte, perché non richiedono
un modello.

Alla fine dimmi quali decisioni dell'elenco non dovrei mai
delegare, e perché.

Attività: [descrivetela in cinque o sei righe]
Il risultato utile è l'ultima risposta. Quasi sempre l'elenco delle cose da non delegare è più corto di quanto temevate e più lungo di quanto speravate, e in mezzo c'è tutto il lavoro che oggi vi porta via i pomeriggi.
Da portare a casa
- Le decisioni ripetitive del vostro lavoro si possono scrivere come domande a risposta chiusa, ed è un esercizio che conviene fare comunque, indipendentemente dallo strumento che userete.
- Il numero che accompagna la risposta è la parte che vi riguarda: permette di fissare una soglia, sopra si procede e sotto ci deve essere il controllo di una persona. La soglia la scegliete voi, e resta scritta.
- La responsabilità professionale non si sposta. Un collaboratore che sbaglia risponde di quello che ha fatto; un modello che sbaglia lascia la responsabilità dove era, cioè a monte, su chi ha deciso la soglia e su chi firma.
Se accedete a Jev il Playground è il punto da cui partire: bastano due minuti e un documento vero.
Happy prompting 🖖
Ti è piaciuta questa issue?
Iscriviti e ricevi la prossima domenica mattina, direttamente nella tua inbox.